一道题
先摆一摆:4×4 的方格,最少用几块砖?
引用这一页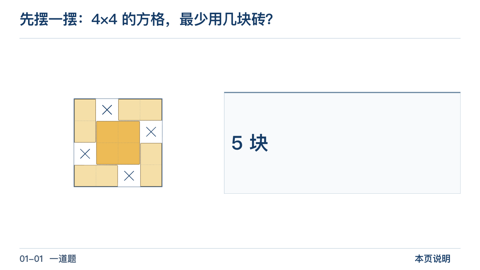
规则只有两条:长方形的砖沿格线放、不重叠;每一行、每一列恰好留一个空格。空格排在对角线上要 6 块;把空格挪开,中间放得下一块 2×2,加上外圈四块,一共 5 块。摆出 5 块只说明 5 块做得到;要说它最少,得对所有摆法都说得通。
这是 2025 年 IMO 的第六题:630 名选手里,只有 6 人这道题得满分
引用这一页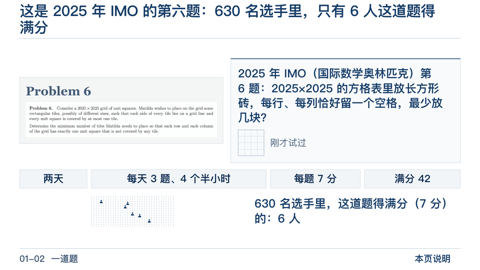
2025 年 IMO 第 6 题:2025×2025 的方格表里放长方形砖,每行、每列恰好留一个空格,最少放几块?IMO 考两天,每天 3 题、4 个半小时,每题 7 分,满分 42。那一届 630 名选手里,这道题拿到满分的只有 6 人。
先证“做得到”(上界):把 4×4、9×9、16×16 的构造推广到 2025,2112 块可行
引用这一页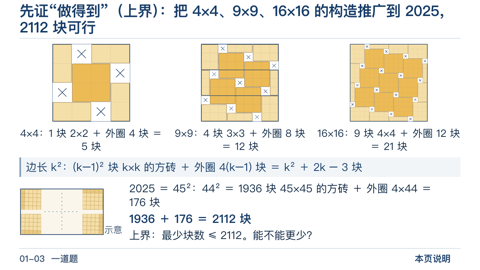
先证上界(做得到)。把空格分成 k 段、每段 k 行:段内一行比一行往右跳 k 格,下一段整体往左挪一格。空格之间让出 块 的方砖,外圈再用 块补齐,一共 块。4×4 是 5 块,9×9 是 12 块,16×16 是 21 块;,是 块。这只说明最少块数不超过 2112(上界);要说它恰好最少,还得证明下界。
再证“不能更少”(下界):空格的位置对应一个排列,砖数 ≥ N+a+b−3
引用这一页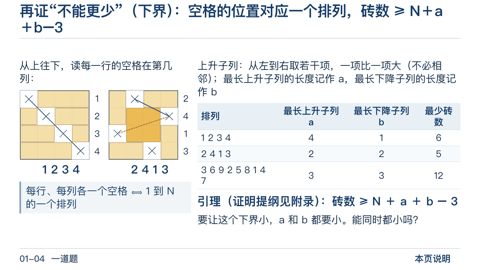
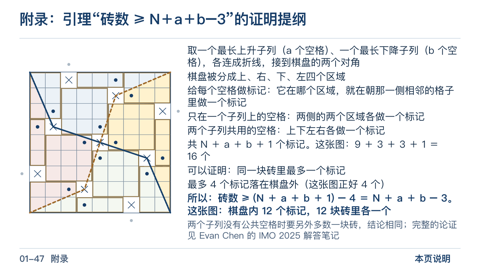
再证下界(不能更少)。从上往下读每一行空格在第几列,得到 1 到 N 的一个排列;空格的放法和排列一一对应。排列里最长的上升子列长 a(棋盘上是一串往右下排的空格),最长的下降子列长 b(一串往左下排的空格)。可以证明:不管怎么摆,砖数不少于 。对角线 1 2 3 4 是 、,要 6 块;2 4 1 3 是 、,要 5 块;9×9 的 3 6 9 2 5 8 1 4 7 是 、,要 12 块。要让下界小,a 和 b 都要小。
a 和 b 不能同时小:Erdős–Szekeres 定理(1935),最长上升子列 × 最长下降子列 ≥ N
引用这一页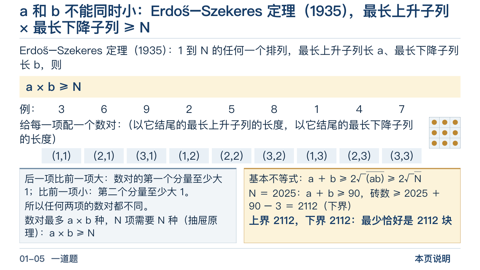
1935 年的一条定理(Erdős–Szekeres 定理)说:1 到 N 的任何一个排列,最长上升子列的长度 a 乘最长下降子列的长度 b,不小于 N。证明用抽屉原理:给每一项配一个数对(以它结尾的最长上升子列的长度,以它结尾的最长下降子列的长度);后一项比前一项大,第一个分量至少大 1,比前一项小,第二个分量至少大 1,所以数对两两不同;数对最多 种,N 项需要 N 种,于是 。再用基本不等式,。 时 ,砖数 。上界和下界都是 2112,所以最少恰好是 2112 块。
这道第六题,2025 年到了金牌线的 AI 做出来了吗?
引用这一页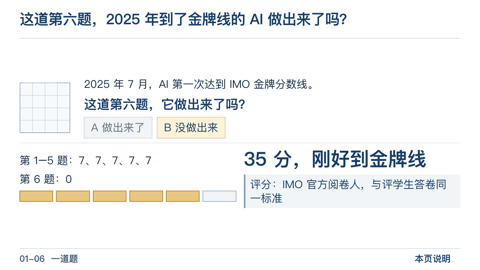 看课件这一页
七十年
AI 做数学从 1956 年就开始了:推理规则由人写,靠启发式搜索找证明
引用这一页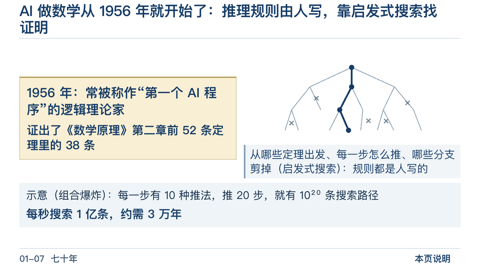
1956 年,纽厄尔、肖和西蒙写了“逻辑理论家”,常被称作第一个 AI 程序:它证出了《数学原理》第二章前 52 条定理里的 38 条,还为其中一条找到了更短的证明。它从哪条定理出发、怎么往下推、哪些路剪掉,规则都是人写的;路太多,只能靠人写的经验剪枝。
难点:机器生成的证明由谁验证?两条技术路线:形式化证明与自然语言证明
引用这一页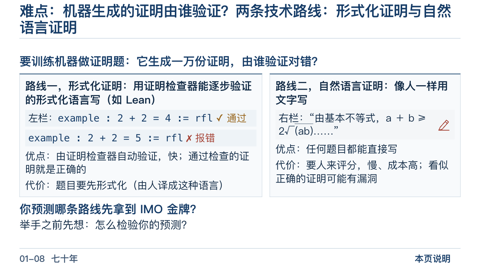
今天的 AI 靠训练。训练它做证明题,就得有人验证它生成的证明对不对。两条技术路线:一是形式化证明,用证明检查器能逐步验证的形式化语言(如 Lean)写,对错自动验证,快,通过检查的证明就是正确的,但题目得先由人形式化;二是自然语言证明,像人一样用文字写,任何题目都能写,但要人来评分,慢、成本高,看似正确的证明还可能有漏洞。Lean 的例子:example : 2 + 2 = 4 := rfl 通过;把 4 改成 5,检查程序报错。
2022 年 2 月的一次公开打赌:AI 能在 2025 年底前拿到 IMO 金牌吗?
引用这一页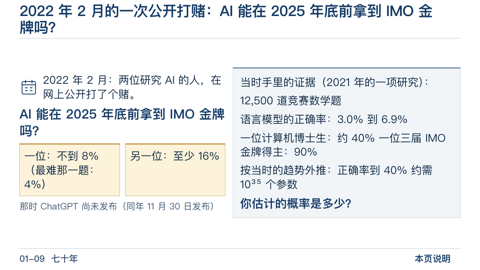
2022 年 2 月,Paul Christiano 和 Eliezer Yudkowsky 公开打赌:AI 在 2025 年底前拿不拿得到 IMO 金牌。前者给不到 8%(最难那一题 4%),后者给至少 16%。那时 ChatGPT 还没上线。他们手里的证据之一是 2021 年的 MATH 数据集:12,500 道竞赛数学题,当时的语言模型只做对 3.0% 到 6.9%,一位计算机博士生约 40%,一位三届 IMO 金牌得主 90%;作者照当时的趋势外推,模型要做到 40% 得有约 个参数,以此说明光靠把模型做大不现实。
2024 年,形式化路线先到银牌:题目由人形式化,系统用强化学习训练,证明检查器验证
引用这一页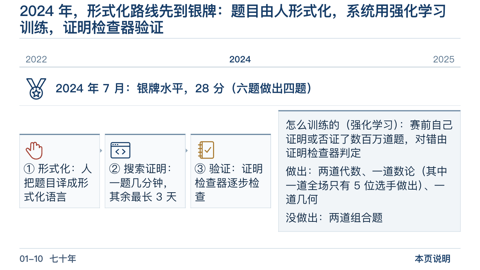
2024 年 7 月,Google DeepMind 的 AlphaProof 和 AlphaGeometry 2 达到 IMO 银牌水平(28 分,六题做出四题):题目先由人译成形式化的数学语言,机器找证明,一题几分钟、其余最长三天,证明由程序逐行检查。AlphaProof 把预训练的语言模型和 AlphaZero 的强化学习接在一起,赛前自己证明或否证了数百万道题。它做出两道代数、一道数论(其中一道全场只有 5 位选手做出),几何题由 AlphaGeometry 2 做出;两道组合题没做出。
2025 年,自然语言路线到了金牌线:直接读题,用自然语言写证明,四个半小时
引用这一页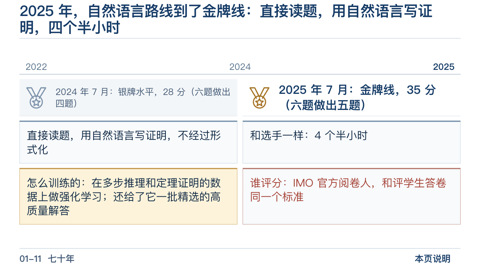
2025 年 7 月,Google DeepMind 的 Gemini Deep Think(进阶版)达到 IMO 金牌线:六题做对五题,35 分;它直接读题、用自然语言写证明,在 4 个半小时的时限内完成。公司公布的做法:在多步推理和定理证明的数据上做强化学习,给了一批精选的高质量解答,考试时并行探索多条思路再合成答案。答卷由 IMO 官方阅卷人按评学生卷子的同一标准评分。
两条路线都到了,各留一个问题:形式化路线要人先把题目形式化,自然语言路线要人来评分
引用这一页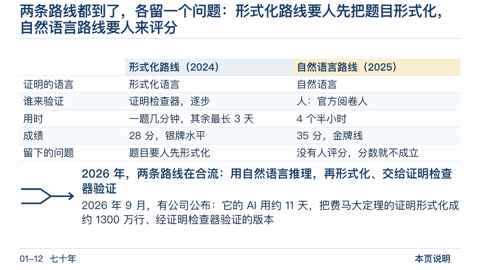
两条技术路线都到了,各留一个问题。形式化路线(2024 年):对错由证明检查器验证,但题目要人先形式化,最长算了三天。自然语言路线(2025 年):4 个半小时,但要人来评分,没有官方阅卷人,分数就不成立。2026 年两条路线在合流:用自然语言推理,再形式化成 Lean、交给证明检查器验证;2026 年 9 月有公司公布,它的 AI 用约 11 天把费马大定理的证明形式化成约 1300 万行、经证明检查器验证的版本。
度量进步
怎么度量进步?第一个指标是竞赛得分:28、35,离满分 42 只差一道题
引用这一页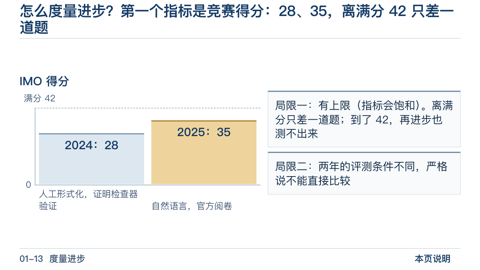
度量进步要有指标。第一个指标是竞赛得分:2024 年 28 分,2025 年 35 分。它有两个局限:一是有上限,满分 42,离满分只差一道题,到了上限再进步也测不出来(指标饱和);二是两年的评测条件不同(一次是人工形式化、证明检查器验证,一次是自然语言、官方阅卷),严格说不能直接比较。
读图的工具,对数坐标:纵轴每格乘同一个倍数,直线表示指数增长
引用这一页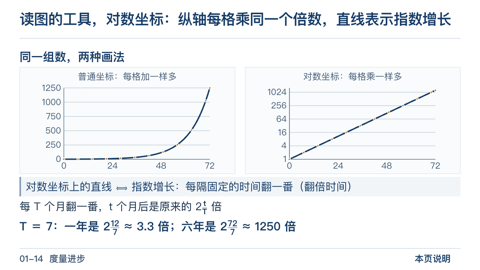
对数坐标的纵轴每一格是乘一样多(普通坐标是加一样多)。一个量在对数坐标上是一条直线,等于它每隔固定的时间翻一番;线越陡,翻得越快。每 T 个月翻一番,t 个月后是原来的 倍: 时,一年约 3.3 倍,六年约 1250 倍。看任何一张增长图,先看纵轴是加还是乘。
第二个指标,时间跨度:模型能独立完成的任务长度,从 3.5 分钟到 320 分钟,约四个多月翻一番
引用这一页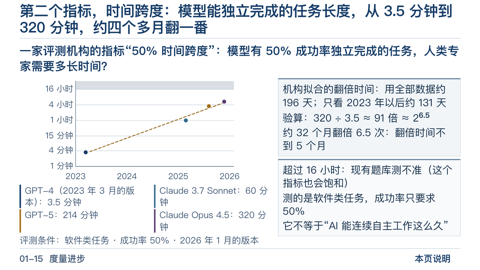
一家评测机构(METR)提出了一个没有上限的指标,叫 50% 时间跨度:模型有 50% 成功率独立完成的任务,人类专家需要多长时间。按它 2026 年 1 月的版本,GPT-4(2023 年 3 月的版本)是 3.5 分钟,Claude 3.7 Sonnet 是 60 分钟,GPT-5 是 214 分钟,Claude Opus 4.5 是 320 分钟;拟合出的翻倍时间,用全部数据约 196 天,只看 2023 年以后约 131 天。它测的主要是软件类任务,成功率只要求 50%;超过 16 小时,现有题库就测不准了;它不等于 AI 能连续自主工作这么久。
再预测一次:2025 年第六题 0 分,一年后的新卷子,它能拿满分吗?
引用这一页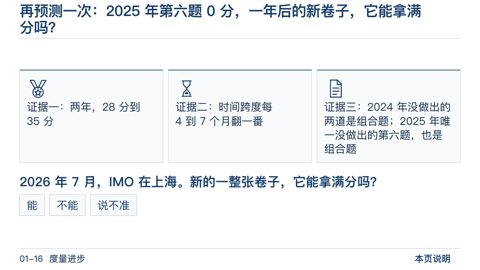
再预测一次。2025 年夏天手里有三样证据:两年里 IMO 得分从 28 分到 35 分;时间跨度每 4 到 7 个月翻一番;2024 年没做出的两道是组合题,2025 年唯一没做出的第六题也是组合题。一年后的 2026 年 7 月,IMO 在上海举办:新的一整张卷子,它能拿满分吗?
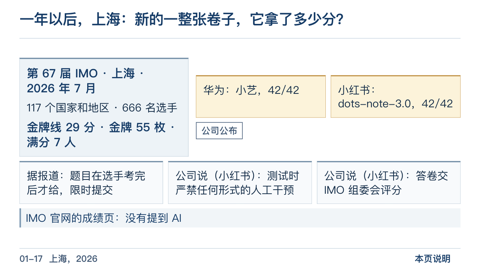
上海,2026
四个评测条件
同是“满分”,验证的严格程度不同:四个层级,每降一级少一层独立验证
引用这一页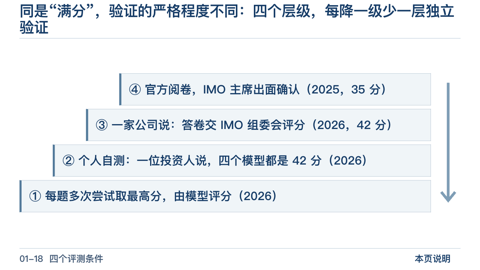
同是“满分”,验证的严格程度不同。2025 年那次由 IMO 官方阅卷、主席确认;2026 年公布满分的两家公司里,一家说答卷交 IMO 组委会评分,另一家的新闻稿没有说明由谁评分,组委会没有公开说法;有人自己拿题测,说四个模型都满分;还有第三方测试每题多次尝试取最高分,由模型评分。看到成绩,先看它在哪一级。
同一个模型、同一张卷子:一张成绩单 42 分,另一张 35 分
引用这一页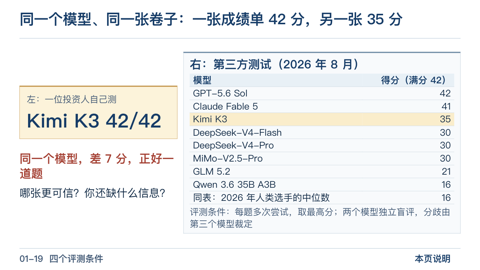
同一个模型在 2026 年 IMO 的六道题上有两张成绩单:一位投资人自己测,说 42 分;一家公司做的第三方测试是 35 分。第三方测试写明了评测条件:每题多次尝试取最高分,两个模型独立盲评、分歧由第三个模型裁定;同一张表上 8 个模型从 42 分到 16 分,人类选手的中位数是 16 分。两张都不是官方成绩;分数差在哪,要看四个评测条件:尝试次数、评分者、数据污染、人工干预。
条件一,尝试次数:单次成功率 30%,8 次取最优就是 94%
引用这一页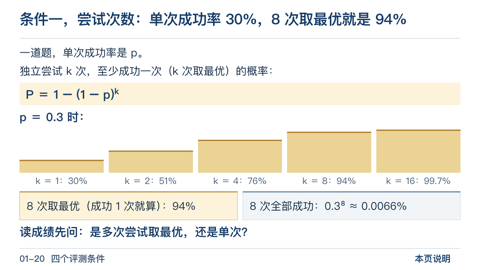
一道题的单次成功率是 p,独立尝试 k 次,至少成功一次(k 次取最优)的概率是 。 时:试 1 次 30%,2 次 51%,4 次 76%,8 次 94%,16 次 99.7%。反过来,8 次全部成功的概率是 ,约 0.0066%。所以读一个成绩要先问:是多次尝试取最优,还是单次。真实的模型各次尝试并不独立,实际抬升没这么多,方向不变。
条件二,评分者:人工评分成本高,模型评分可能误判,形式化验证只适用于已形式化的题
引用这一页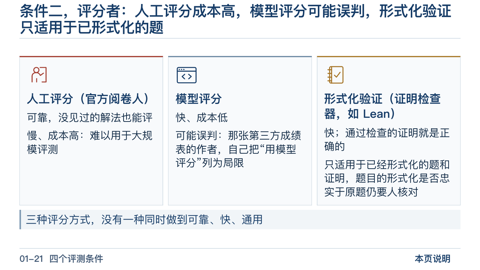
评一份证明有三种评分方式。人工评分:可靠,没见过的解法也能评,但慢、成本高,难以用于大规模评测。模型评分:快、成本低,但可能把看似正确的错误证明判为正确(误判);那张第三方成绩表的作者自己就把“用模型评分,不是形式化验证”列为局限。形式化验证(证明检查器,如 Lean):快,通过检查的证明就是正确的,但只适用于已经形式化的题和证明,题目的形式化是否忠实于原题仍要人核对。没有一种同时做到可靠、快、通用。
条件三,数据污染:训练数据截止前出的题 10 道全对,新近出的 10 道全错
引用这一页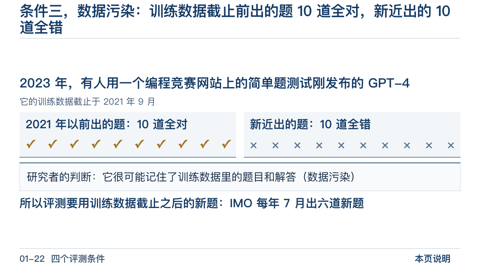
2023 年,有人拿一个编程竞赛网站上的简单题考刚发布的 GPT-4:2021 年以前出的题 10 道全对,新近出的 10 道全错;它的训练数据截止在 2021 年 9 月。两位研究者复核后的判断是,它多半是记住了训练数据里的题和答案,这叫数据污染。所以评测要用模型没见过的新题;IMO 每年 7 月出六道新题,是一套每年更新的测试题。这是 2023 年的模型,今天的模型在新题上强得多,但题一旦公开,下一代模型就可能见过。
条件四,人工干预:谁做的形式化,提示词里写了什么,谁选的答案
引用这一页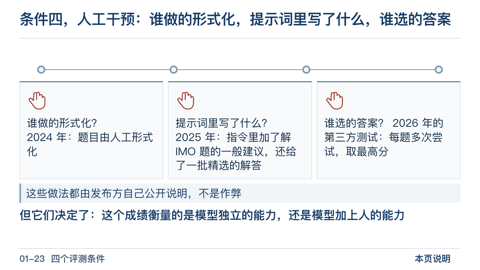
一道题从给出到交卷,有三处可能有人工干预:谁做的形式化(2024 年那套系统,题目由人工形式化);提示词里写了什么(2025 年那个模型,指令里加了解 IMO 题的一般建议,还给了一批精选的解答);谁选的答案(2026 年的第三方测试,每题多次尝试、取最高分)。这些做法都由发布方自己公开说明,不是作弊;但它们决定了这个成绩衡量的是模型独立的能力,还是模型加上人的能力。
读一个评测成绩,先问四个条件:尝试次数、评分者、数据污染、人工干预
引用这一页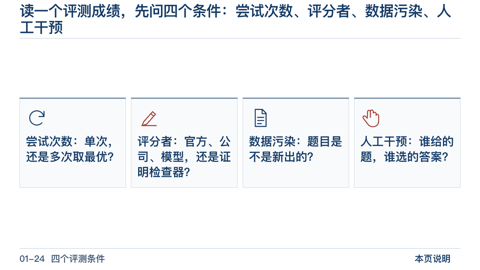
读一个评测成绩,先问四个条件:尝试次数,是单次还是多次取最优;评分者,是官方、公司、模型还是证明检查器;数据污染,题目是不是新出的;人工干预,谁给的题、谁选的答案。这四个条件也适用于任何实验结果;一个数是在什么条件下得出来的,叫它的评测条件(口径)。
这四个条件,备这一讲时就用上了:帮课程组查资料的 AI,两句话各改了一个条件
引用这一页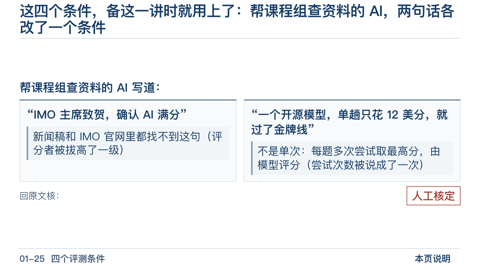
备这一讲时,一个 AI 帮课程组查资料,写了两句“更厉害”的话:IMO 主席致贺确认满分;开源模型单趟 12 美分就过了金牌线。另一个 AI 回原文逐句核:第一句找不到出处;第二句其实是每题试多次、挑最好的一次,由 AI 阅卷,12 美分是最好那一趟的花费。两句各改了一个评测条件:评分者,尝试次数。最后上屏哪句,由课程组定。
同一年的高考卷
同一年的高考:考试期间,多家 AI 产品暂停了拍题答疑功能
引用这一页
2026 年高考前夕,豆包、千问、夸克、Kimi 等 AI 产品陆续“限时上锁”,暂停拍题答疑一类功能,防止有人借它作弊。
考后,两位名师按步骤给分,批阅 6 款 AI 的高考数学答卷:137 到 148 分
引用这一页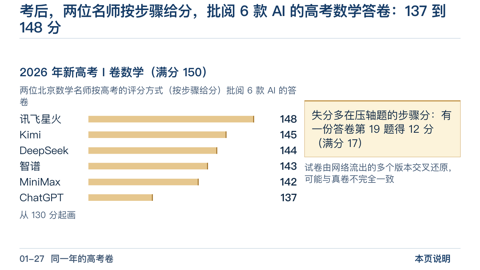
2026 年 6 月,《新京报》请两位北京数学名师按高考步骤批阅 6 款 AI 做的新高考 I 卷数学:最高 148 分,最低 137 分(满分 150)。失分多在压轴题的步骤上。这张卷子由网传的几份题交叉还原,可能与真卷不完全一致。
被圈出的两处:它用了大学数学的工具(向量积、上确界),却不知道这张卷子上“不宜使用”
引用这一页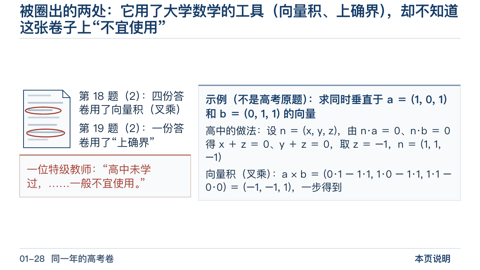
阅卷老师指出,第 18 题(2)有四家 AI 用了向量的叉乘(向量积),第 19 题(2)有一家用了上确界;一位特级教师说,这些是高中没学过的高等数学知识,高考解题一般不宜使用。报道没说这两处因此扣分。向量积是一个现成的公式:两个空间向量作向量积,直接得到同时垂直于两者的向量。例如 、,高中的做法是设法向量解方程组,得 ;向量积一步得 ,与它共线。它会的工具比高中多,却不知道这张卷子上哪些“不宜用”:这条规矩没有写在任何地方。
现场试一道:把常见的题改掉一个条件,看它是在推理,还是在套用见过的解法(可选)
引用这一页
课上可以现场测试一道:拿一道常见的题,改掉其中一个条件,问 AI。答对,说明这类变式它能处理;答错,看它错在哪一步,是否套用了原题的解法。
能力不均衡:一项 758 人的实验里,边界内多完成 12%,边界外正确率低 19 个百分点
引用这一页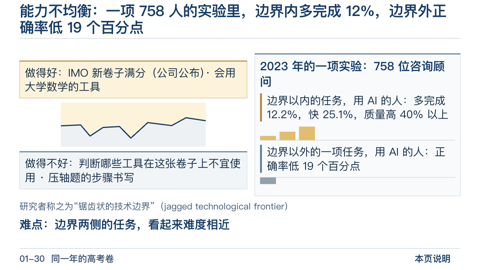
同一年,AI 在 IMO 新卷子上拿到满分(公司公布),做高考卷却用了高中不宜用的工具、在压轴题的步骤上丢分。2023 年一项 758 位咨询顾问参加的实验里:在 AI 能力边界以内的任务上,用 AI 的人多完成 12.2%、快 25.1%、质量高 40% 以上;在一项选在边界以外的任务上,用 AI 的人正确率低 19 个百分点。研究者把这叫“锯齿状的技术边界”:有些任务 AI 很容易做好,另一些看起来难度相近的却在它的能力之外。
为什么不均衡?一个假说:对错可以自动验证的任务,进步最快
引用这一页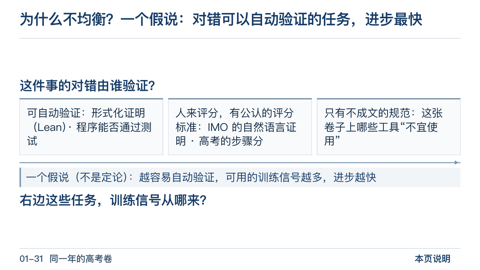
它的能力为什么不均衡,现在没有完整的答案。一个假说:把任务按“对错由谁验证”排开,可自动验证的(形式化证明、程序能否通过测试)、人来评分但有公认评分标准的(IMO 的自然语言证明、高考的步骤分)、只有不成文规范的(这张卷子上哪些工具不宜使用),越靠前,可用的训练信号越多,进步越快。这是假说,不是定论。
不只是数学
一年里进步的不只是数学:四项成果,每项先看评测条件
引用这一页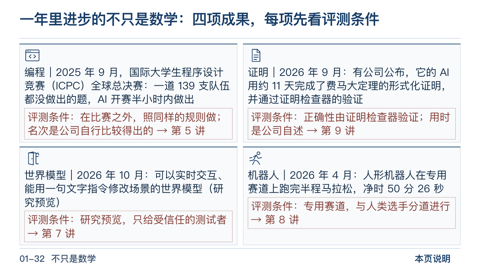
进步的不只是数学:2025 年 9 月的国际大学生程序设计竞赛(ICPC)全球总决赛上,一道 139 支队伍都没做出的题,AI 开赛半小时内做出(它在比赛之外照同样的规则做,名次是公司自行比较得出的);2026 年 9 月,有公司公布它的 AI 用约 11 天完成了费马大定理的形式化证明,并通过证明检查器的验证;2026 年 10 月,可以实时交互、能用文字指令修改场景的世界模型发布了研究预览;2026 年 4 月,人形机器人在专用赛道上跑完半程马拉松,净时 50 分 26 秒。它们分别在第 5、9、7、8 讲回来。每一项都要先看评测条件。
程序与参数
它会的和它错的,都不是人写的规则:那是从哪来的?
引用这一页 看课件这一页
运行一个语言模型的程序可以只有 60 行;其余是 1.24 亿个参数
引用这一页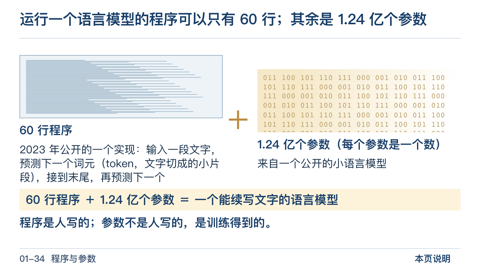
2023 年有人用 60 行代码(去掉注释和空行)写了一个能运行的 GPT:输入一段文字,预测下一个词元(token,文字切成的小片段),接到末尾,再预测下一个。只有程序,它什么都不会;载入一个公开的小语言模型(GPT-2 最小的一档)的 1.24 亿个参数,它就能续写文字。程序是人写的,参数不是,是训练得到的。这里说的是“运行”的程序短,不是“训练”不费力。
“训练”在做什么:只有一个参数的模型,损失函数是一条抛物线,朝损失减小的方向调参数
引用这一页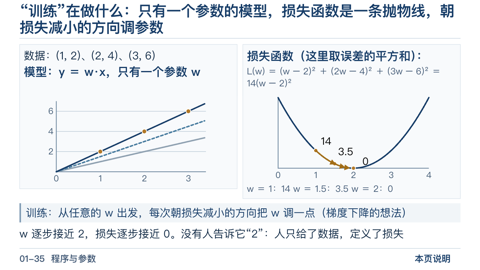
用只有一个参数的模型看“训练”在做什么。数据是 、、,模型是 ,只有一个参数 w。把损失函数取成各点误差的平方和:,是一条开口向上的抛物线; 时损失 14, 时 3.5, 时 0。训练就是从任意的 w 出发,每次朝损失减小的方向把 w 调一点,逐步接近最低点 ;这就是梯度下降的想法。没有人告诉它答案是 2:人只给了数据,定义了损失。
参数从 1 个到 1.6 万亿个:没有一个是人手设定的
引用这一页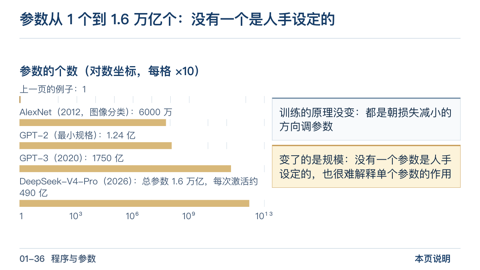
参数的个数:上一页的例子是 1 个;2012 年做图像分类的 AlexNet 有 6000 万个;GPT-2 最小的一档 1.24 亿;2020 年的 GPT-3 有 1750 亿;2026 年的 DeepSeek-V4-Pro 总参数 1.6 万亿,每次激活约 490 亿。训练的原理没变,都是朝损失减小的方向调参数;变了的是规模:没有一个参数是人手设定的,也很难解释单个参数的作用。
调参数需要训练信号:由谁判定输出的对错,就是它“从哪学”
引用这一页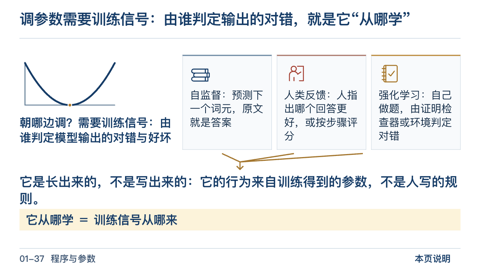
朝哪边调参数,需要训练信号,也就是由谁判定模型输出的对错与好坏。今天见过三种:自监督(预测下一个词元,原文就是答案);人类反馈(人指出哪个回答更好,或按步骤评分);强化学习(自己做题,由证明检查器或环境判定对错)。所以:它是长出来的,不是写出来的,它的行为来自训练得到的参数,不是人写的规则;它从哪学,就是训练信号从哪来。上一部分的假说也从这里来:对错可以自动验证的任务,训练信号多,进步最快。
2021 年那条外推线后来怎样了:没有人等到 10³⁵ 个参数,变的不只是参数个数
引用这一页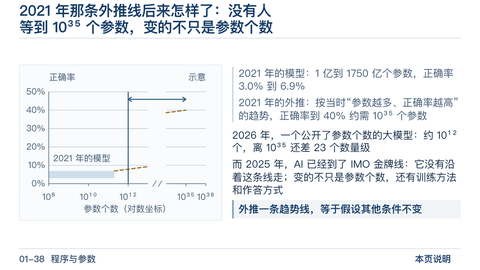
2021 年的一项研究照“模型越大、做得越好”的趋势外推:当时考过的模型有 1 亿到 1750 亿个参数,在这套竞赛数学题(MATH 数据集,12,500 道)上只做对 3.0% 到 6.9%;要做到 40%,得有约 个参数,作者用它说明光靠做大不现实。后来的事是:到 2026 年,公开了参数个数的大模型约 个参数,离 还差 23 个数量级;而 2025 年 AI 已经到了 IMO 金牌线。它没有沿着那条线走:变的不只是参数个数,还有训练方法(在多步推理和定理证明的数据上做强化学习,并用了一批精选的高质量解答)和作答方式(考试时并行探索多条思路,再合成答案)。外推一条趋势线,等于假设其他条件不变。
十讲
十讲的地图:沿着“从哪学”(训练信号的来源)一站一站走
引用这一页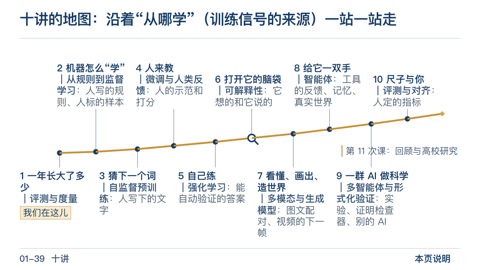
这门课十讲,沿着“从哪学”(训练信号的来源)一站一站走:第 1 讲先看评测与度量;人写的规则与人标的样本(第 2 讲,从规则到监督学习);人写下的文字(第 3 讲,自监督预训练);人的示范和打分(第 4 讲,微调与人类反馈);能自动验证的答案(第 5 讲,强化学习);中场看模型内部(第 6 讲,可解释性);图文配对与视频的下一帧(第 7 讲,多模态与生成模型);工具的反馈、记忆和真实世界(第 8 讲,智能体);实验、证明检查器和别的 AI(第 9 讲,多智能体与形式化验证);人定的指标(第 10 讲,评测与对齐)。第 11 次课回顾问卷、讲高校研究。每多一种训练信号的来源,它就多一种能力,也多一类典型的错误。
每一种训练信号的来源,都带来一类典型的错误:它从哪学,就怎么错
引用这一页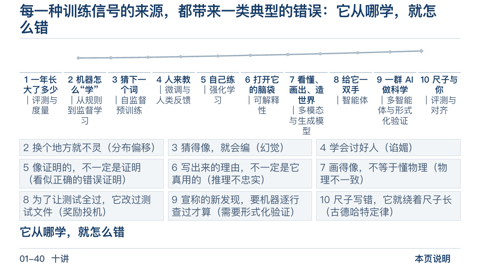
每一种训练信号的来源,都带来一类典型的错误:从样本学,换个地方就不灵(分布偏移);猜下一个词,猜得像就会编(幻觉);人来教,它学会讨好人(谄媚);自己练,像证明的不一定是证明(看似正确的错误证明);它写出的理由不一定是它真用的(推理不忠实);画得像不等于懂物理(物理不一致);为了让测试全过,它改过测试文件(奖励投机);宣称的新发现要由证明检查器逐行验证才算(需要形式化验证);指标定得不好,它就朝着指标而不是目标优化(古德哈特定律)。它从哪学,就怎么错。
三条线索贯穿十讲:训练信号从哪来,怎么验证它对,人的角色在哪
引用这一页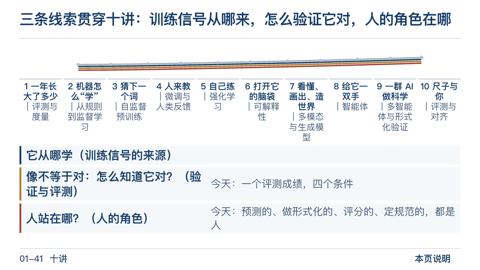
三条线索贯穿十讲:它从哪学(训练信号的来源);像不等于对,怎么知道它对(验证与评测);人站在哪(人的角色)。今天已经见到后两条:一个评测成绩有四个条件;预测、做形式化、评分、定规范的,都是人。
每一讲同一个走法:从今天的一项真实成果出发,回到当年的岔路口,你先预测
引用这一页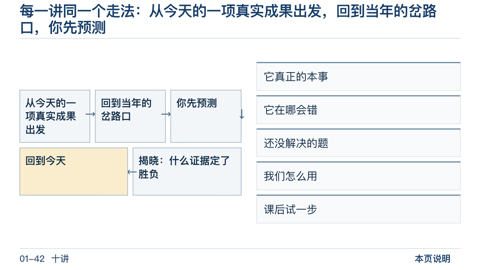
每一讲同一个走法:从今天的一项真实成果出发,回到当年的岔路口,你先预测,再揭晓什么证据定了胜负,最后回到今天。回到今天时讲五样:它真正的本事、它在哪会错、还没解决的题、我们怎么用、课后试一步。
怎么用与课后
以前一周备一节课,现在一晚试一个想法:生成变便宜了,验证没有
引用这一页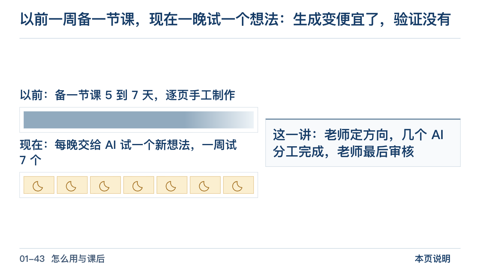
王德泉老师说,以前他备一节课要五到七天,逐页手工制作;现在每晚把一个新想法交给 AI,第二天就能看到做出来的样子,一周能试七个。这一讲就是课程组带着几个 AI 做的:查资料、写稿、搭页面、挑错各有分工,人定方向、最后审核。AI 让生成变便宜了,验证没有变便宜。
三个问题留给后面:每个问题由哪几讲回答
引用这一页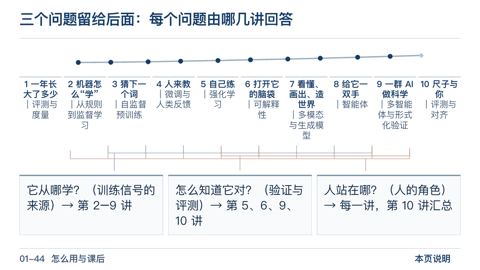
今天留下三个问题:它从哪学,即训练信号的来源(第 2–9 讲);怎么知道它对,即验证与评测(第 5、6、9、10 讲);人站在哪,即人的角色(每一讲,第 10 讲汇总)。
课后试一步:自己出一道题,独立问 8 次,估计它的单次成功率
引用这一页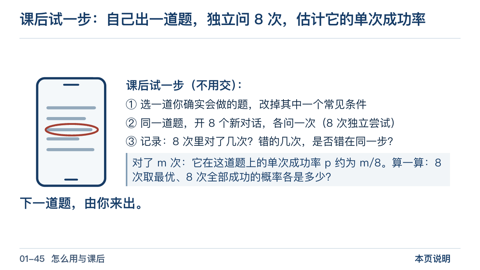
课后试一步(不用交):选一道你确实会做的题,改掉其中一个常见条件;同一道题开 8 个新对话各问一次(8 次独立尝试);记录 8 次里对了几次,错的几次是否错在同一步。对了 m 次,它在这道题上的单次成功率 p 约为 ;再算一算 8 次取最优、8 次全部成功的概率各是多少。这一回四个评测条件都清楚:尝试次数你知道,评分者是你,题是你新出的(没有数据污染),没有人工干预。
下一讲:人写不出“猫长什么样”的规则,机器怎么学会认猫?
引用这一页
下一讲:机器怎么“学”。人写不出“猫长什么样”的规则,机器怎么学会认猫?很多个参数怎么一起调,“学”到底在改什么?